2022年5月14日 星期六

瘋潮行銷

瘋潮行銷:華頓商學院最熱門的一堂行銷課!
Jonah Berger
社會流行 social epidemic
社會影響力 social influence
感染力六大原則 STEPPS
原則一 社交身價 Social Currency
 - 內在獎勵intrinsically rewarding
 - 讓人們在聊起你的產品、創意或理念時,可以提升他們的形象:
 (1)找出產品、創意或理念的內在不可思議
 (2)運用遊戲機制
 (3)讓人覺得自己是內行人
原則二 觸發物Triggers
 - 即時性口碑VS持續性口碑
原則三 情緒Emotion
原則四 曝光Public
  - 創造行為痕跡 behavior residue
 - 社會認同 social proof
 - 從眾心理herd mentality
原則五 實用價值Practical Value
- 如果說社交身價關係著資訊發送者和他們的面子,那麼實用價值多半為的是資訊接收者。
實用價值是為了幫助別人節省時間或金錢,抑或讓他們能體驗美好事物。
當然,分享具實用價值的資訊對分享者也有一些好處,除了幫助別人感受良好,
也會讓人對分享者留下良好印象,稍微增進其社交身價。
 - 期望理論 prospect theory
 - 有感度遞減 diminishing sensitivity
原則六 故事Stories

2022年4月9日 星期六

因果經濟學:數據氾濫時代,不可或缺的商業教養

因果經濟學:數據氾濫時代,不可或缺的商業教養

- 掌握因果關係的五步驟
1.「原因」是什麼?
2.「結果」是什麼?
3.確認三項要點
   (1)是不是「純粹的巧合」?-- 偽關係
   (2)是否存在著「第三變數」?-- 是否存在同時影響原因、結果雙方的「第三變數」,
其專有名詞為「混淆因素」。會讓單純只有相關關係的事物,看起來彷彿具有因果關係。
   (3)是否存在著「反向因果關係」?
4.創造出反事實
- 為了證明因果關係的存在,必須試圖比較原因發生時、「事實」情況下的結果;
以及原因未發生時、「反事實」情況下的結果。
5.調整至具可比較性
若在兩個群組之間,人口、平均所得、對流行的敏銳度等可能會影響珠寶飾品營業額的所有特徵都相差無幾,兩個群組之間的唯一差異就是「有沒有刊登廣告」的話,我們就可以稱此兩群組具有「可比較性」。
- 所有方法的共同目標都是「創造出具可比較性的群組,並用近似值代入反事實」。

第三章 男性醫師是否比女性醫師更優秀? 
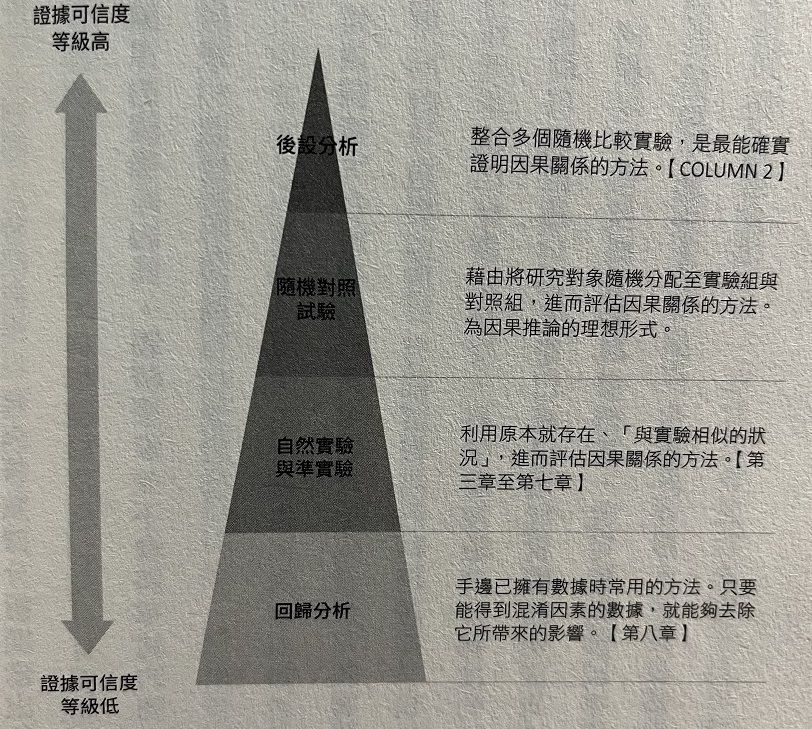
- 隨機對照試驗在證據等級上的可信度很高,但是要實際執行隨機對照試驗並不是件容易的事。
- 使用隨機對照實驗,收集而來的數據稱為「實驗數據」,
而像這樣從日常經濟活動的結果中得到的數據,則稱為「觀察數據」。
- 自然實驗:是指透過法律或制度的變更、自然災害等「外部衝擊」的影響,
自然地讓研究對象被分為受干預的群組(實驗組)與未受干預的群組(對照組),
研究者利用這樣的狀況,進而檢驗因果關係。

第四章 增設合法保育所,母親就能去上班嗎? 
- 模擬實驗的「準實驗」:
是利用觀察數據與統計方法,創造出與隨機對照試驗非常相似的狀態。
將介紹以下四種「統計方法」:
1.差異中之差異法
2.工具變數法
3.斷點回歸設計
4.配對法
-改良事前事後比較研究的「差異中之差異法」:和事前事後比較研究不同的是,
差異中之差異法必須具備充當反事實的「對照組」。
- 差異中之差異法:是在受干預的群組(實驗組)與未受干預的群組(對照組)之中,
取出干預前後的結果差異、以及干預後實驗組和對照組的差異;再取上述兩項差異的差。
但是,這項方法必須滿足兩項先決條件才會有效。
第一項條件:是實驗組與對照組在干預前的「趨勢」結果必須相同,
也就是「趨勢」必須具「可比較性」。
第二項條件:是在干預的時間點,實驗組與對照組之中並未個別出現其他可能會影響結果的變化。

第五章  看電視會降低孩子的學習力嗎?    
- 工具變數法:利用「只能透過影響原因、間接影響結果」的工具變數,
讓受到干預的群組(實驗組)與未受干預的群組(對照組)具可比較性。
若要讓這個方法有效,必須滿足兩項先決條件。
第一項條件:是工具變數雖然會影響原因,但不能直接影響結果;
第二項條件:則是這其中不存在會同時影響工具變數與結果的第四變數。

第六章 和會讀書的朋友來往,學習力就能提升嗎? 
- 斷點回歸設計:將任意決定的閥值兩側分為實驗組與對照組,藉此推斷因果效應的方法。
要讓斷點回歸設計成立的先決條件,是確保閥值附近沒有任何其他可能會影響結果的事件。

第七章 就讀偏差值高的大學,收入就會提升嗎? 
- 「傾向分數」是將複數的共變量統整為一個分數,再利用該分數進行配對。
所謂的傾向分數,就是指「能對應到實驗組的機率」。
- 所謂的共變量,指的是扣除原因與結果之後剩下的所有變數。
比方說,在你手邊已有數據時,除了原因與結果以外的變數皆是共變量。
混淆因素則是共量變之中「同時對原因與結果帶來影響」的變數。
也就是說,在共變量之中,包含混淆因素與並非混淆因素的變數。
- 配對法:這項方法,使用可能會影響結果的共變量,從對照組之中找出與實驗組非常相似的樣本進行配對,並進而比較的方法。
在有許多共變量的情況之下,可將所有共變量統整為一項數值進行配對(傾向分數配對)。
讓配對法成立的先決條件,是必須能夠觀測所有可能對結果造成影響的共變量。

第八章    便於分析現有數據的「回歸分析」
- 以色列裔美籍計算機科學家茱迪亞·珀爾(Judea Pearl)開發出利用DAG圖(因果圖)
來釐清因果關係的方法。在此之後,透過哈佛大學的James Robins,Miguel Hernan以及
加州大學洛杉磯分校的Sander Greenland等人的努力,因果圖開始被醫學與流行病學所廣泛接受。
- 由於混淆因素是「對原因與結果雙方帶來影響的第三變數」,
因此,當劃出同時往原因與結果的雙向箭頭時,這個第三變數就能被視為混淆因素。
- 一旦確定出混淆因素,就必須使用配對法或複迴歸分析來去除混淆因素的影響,
否則就無法正確定評估因果關係。
相對地,若從原因指向第三變數的箭頭方向顛倒時,我們就能得這個第三變數並非混淆因素(由於他位於因果關係的中途點,又被稱為「中介變數」。
萬一用複迴歸分析處理中介變數,就會低估原因本來會造成的影響。

延伸閱讀:
-哈佛大學經濟系知名計量經濟學家圭多·因本思Guido Imbens、
麻省理工學院的勞動經濟學家約書亞·安格里斯特,和唐納德·魯賓合著-
魯賓因果推論模型(Rubin Causal Model)。
-魯彬與因本思共著-Causal Inference for Statistics,Social,and Biomedical Sciences:An Introduction

分析的「效度」與「極限」
- 內部效度指的是兩個變數之間,具有因果關係的可信度。
也就是當同一批研究對象群組再次受到相同的干預時,就能夠在多大的程度上得到相同的結果。
相對地,外部效應是指當不同於原先研究對象的群組受到相同干預時,能夠在多大的程度上得到相同的結果。

2022年2月1日 星期二

不理性的力量

不理性的力量:掌握工作、生活與愛情的行為經濟學
The Upside of Irrationality
Dan Ariely
第1章  給的愈多,得的愈少
- 表現焦慮(Performance Anxiety):工作表現動機過高會招致反效果的基本模式。

第2章  工作的意義
- 福特(Henry Ford)和「科學管理之父」泰勒(Frederick Winslow Taylor)將專業分工的概念拓展到
生產線上,發現專業分工有助減少錯誤、提升生產力。
- 德國哲學家、政治經濟學家、社會學家、革命家,以及「共產主義之父」馬克思(Karl Marx)
點出所謂「勞動異化」(The alienation of labour)的重要性。
一位「異化」的勞工將對自己所做的工作、勞動目標,以及生產的流產產生疏離感。
這將使的工作成為事不關己的「外部性活動」(external activity),
因而讓人無法在工作中找到認同感及意義。
- 專業分工會是產業科技可能帶來危險之一。
現代資訊科技使我們得以將工作細分為更多互不相干的部分,並指派不同的人來負責其中各個部分。
如此一來,企業就有可能產生員工無法看清全局、工作意義,以及工作成就感被剝奪的風險。
如果我們都是機器人,高度分工或許真能帶來效率。
但若考慮內在激勵因素(internal motivation)以及工作意義對人類工作動力及生產力的重要性,
專業分工卻有可能產生負面效應。

第4章  「非我族類」症候群
- 馬可吐溫的一篇散文<集體蠢行>(Some National Stupidities)提及:
要世界上某部分人去運用另一部分人的智慧結晶時,大家的反應似乎特別遲緩,
這種情況真是令人費解。這類蠢行舉世皆然,並不限於某社群或某國家。
事實上,人類在接納別人的意見及作法上不但反應遲緩,有時甚至根本採取抗拒的態度。
- 「非我族類」症候群(Not-Invented-Here,簡稱為NIH),
意思就是:【如果不是我(或我們)想出來的,他就完全不值一顧。」
- 一種可能是,客觀而言他們提出的解決方案確實比較好。
另一種可能是,即使他們的想法並不比較高明,但他們的解決方案卻比較符合他們自己的價值觀,
這個現象稱為「特性配適」(idiosyncratic fit)。
- 參與者內設計(within-participant design):每位參加者都以自己為對照組。

2022年1月20日 星期四

行銷源典:任意行銷首部曲

行銷源典:任意行銷首部曲

第一篇 前傳:行銷歷史與行銷學派
行銷哲學的核心思維與定義
- 管理領域中程序學派講求的是管理者對事的管理,主要討論如何計畫、組織、與控制等議題。
行為學派講求的是管理者對人的管理,主要討論溝通、激勵、與領導等方法。
管理科學學派探討的是管理者如何做決策。制定決策牽涉到兩種管理技能,
一是預測,對未來的情勢進行預測,二是資源的最適配置,思考何時應該用多少人做多少事。
預測源自於統計學的訓練,而資源最適配置則奠基於管理數學的訓練。
- 行銷之所以有別於管理,主要的原因是管理著重企業內部的效率,
而行銷則強調企業從外部去開創或創造市場。
- 企業經營活動大體分為兩類,價值創造(value creation)與價值專屬(value appropriation)。
價值創造的活動,意指企業透過研發產生出創新的構想。
價值專屬,意指企業使其創造的價值能被消費者接受,最終完成交換、獲取財貨,
以實現企業所創造的價值,並且該價值能專屬於公司。

消費者行為的異質性與動態性
- 行銷人員必須要掌握住兩個關鍵的消費者行為的特質:異質性與動態性。
- 消費者各有不同的出生背景、人格特質、生活經驗,造就出每一個消費者的思考、行為、
需求各有特色,這就是消費者的異質性。市場上消費者的差異很大,
由於消費者的異質性很高,反映出市場上充滿各種不同的需求。
身為行銷人員最大的責任,便是時時刻刻注意市場上是否存在不同的消費需求。
- 行銷管理提供的是行銷理論的基本功,若是想要針對消費者行為有更深入的了解,
可以參考消費者行為的相關理論。而行銷實務技術可以參酌行銷研究的方法,
進一步學習如何尋找與分析消費者的異質性。
- 消費者的行為不僅僅是人與人的差異性,同一人的行為在不同時間點也會有所差異,
這就是所謂的動態性。

行銷修練的四大學派
*實體配送通路學派(Physical Distribution and Channel)
*消費者行為學派(Consumer Behavior)
*行銷策略學派(Strategic Marketing)
- 行銷策略學派告訴行銷人員除了要先了解消費者之外,更要積極地透過與競爭對手的差異化策略,
進一步形塑消者不同的需求與認知,以改變市場的遊戲規則。
相較於消費者行為學派著重回應消費者需求的前提假設,並以此假設作為發展行銷策略的限制條件;
行銷策略學派出截然不同的觀點,認為消費者需求不該是發展行銷策略的限制,
廠商可以利用本身資源的優勢,透過行銷策略來形塑消費者行為。
*行銷決策模式學派(Marketing Decision Models)
- 行銷決策模式學派的基礎訓練是統計,將統計應用於分析大量的交易資料,並且隨著顧客交易資料庫的發展,統計方法也漸趨複雜。
- 行銷決策模式學派之所以重要,是因為行銷人員可以觀察到消費者的實際購買行為,學術研究也開始可以回頭檢視許多行銷理論的真諦,使行銷的思惟也產生重大的轉變。
例如傳統行銷強調的是完成交易,然而隨著資料庫的發展,行銷人員可以觀察消費者的歷史動態,開始思考與消費者建立長期關係。現今所討論的顧客關係,是透過電腦的協助,進行大量的客製化的行銷策略,以便於管理動輒上百萬顧客人數的關係。
- 顧客關係的建立需以個體或個人為基礎,所以從橫剖面的層次觀之,行銷人員對於不同的客戶要維繫不同的關係「異質性」;從縱斷面的角度論之,行銷人員對於同一客戶在不同的時點上要有不同關係維繫的作法「動態性」。
資料庫行銷簡單的說就是依據客戶資料庫中各項有關客戶交易行為的歷史紀錄、產品編碼知識庫以及個人資料庫等,透過現代高等統計分析的決策模式,以掌握客戶行為的異質性與動態性。
- 行銷人員如果要精通行銷,應該對於四個學派的基本訓練「數學、心理、經濟、統計」及其相關的研究都要有很深入的了解與吸收,如此才能掌控日益複雜的市場環境、變化詭異的競爭態勢、與捉摸不定的消費行為。
- 消費者行為學派告訴我們要先了解消費者的想法與行為,然後按照消費者的想法與需求來設計企業的行銷策略,去因應(to adapt)、回應(to respond)、滿足(to satisfy)消費者的需求。這種被動回應消費者需求的概念,稱之為被動式行銷典範。
八十年代策略學派興起後,告訴我們廠商除了要了解消費者之外,可以依照自己的資源優勢,試圖去主動地重新塑造消費者需求或行為,以求與競爭對手進行差異化,這種根據策略學派所發展的行銷策略思惟,稱為主動式行銷典範。
- 到了1990年代,行銷決策模式學派伴隨著企業開始建立客戶資料庫而逐漸興起。由於資料庫的建立,廠商除了可以透過資料庫觀察到個別顧客最近一次的交易資料,更可以看到該名顧客的所有歷史交易資料,透過行銷決策模式學派所研究的資料分析方法,廠商可以做到大量客製化,開始與個別顧客進行一對一的互動,與顧客建立長期互動關係。
這種形式之下的行銷哲學思維稱之為互動式行銷典範。

第二篇 演化:行銷思潮之典範移轉
滿足消費者之所需——被動式行銷典範
- 被動式行銷典範的起源是消費者導向,所有一切的行銷策略都是反映消費者的行為或需求狀況。所以前提是:行銷人員是否了解你的消費者?這點牽涉到理論的基礎與實作的方法。
理論的基礎來自心理學的學理基礎,例如消費者對於行銷資訊如何擷取、在腦中如何儲存等等問題。此外針對特定的產品,消費者又是如何選擇?市場競爭態勢又是如何?
對於這些問題,要用什麼方法來了解市場上消費者的認知與態度,
行銷人員必須熟悉許多統計數量的分析工具,亦即行銷研究所介紹的市場調查、統計分析等。

塑造消費者之所需——主動式行銷典範
- 主動式行銷是競爭導向的思維,主張行銷人員除了要了解市場消費者之外,也要了解市場上競爭者的策略。相對於被動式行銷強調由外而內(out-side-in)的觀點,也就是外部消費者的偏好決定廠商所需提供的產品服務;主動式行銷典範則是一種由內而外(inside-out)的觀點,強調企業以本身內部資源優勢為出發點,試圖去改變外在市場環境或塑造消費者行為。
因此,主動式行銷主張供給形塑需求(Supply shapes demand)。
對行銷人員而言,影響或塑造消費者就是要改變消費者的消費習性,或是改變消費者的決策準則。

客製化消費者之所需——互動式行銷典範
- 交易行銷與關係行銷之比較

數位化消費者之所需——連鎖式行銷典範
- 要產生像Amazon.com產品推薦系統那樣的推薦機制,只要透過統計裡簡單的相關係數(correlation coefficients)就可以產生。根據顧客實際交易資料,可以從資料庫中整理出一張橫軸是書本、縱軸是顧客的表格(即所謂的flat file),這張表格記錄著每一個消費者購買過哪些書籍。
根據這個資料表中的數據可以計算不同書本之間的相關係數。
當某兩本書之間的相關係數越接近1.0時,代表這兩本書同時被消費者購買的機率越高。

2021年11月20日 星期六

成長駭客行銷:引爆集客瘋潮的新實戰力

 成長駭客行銷:引爆集客瘋潮的新實戰力


- 行銷過去是以品牌為基礎,成長駭客則以投資報酬率和量化指標為導向。
- 黏著度(Stickiness):服務或產品的黏著度,可想像成用戶再次購買產品或推薦給別人的可能性。
- 不管哪個行業,成長駭客行銷心態全都適用:
確保服務不可或缺、尋找漏洞或發展不完全的利基市場、鼓勵口耳相傳,
並根據數據和用戶意見不斷優化。

- 關鍵字:
- 同類群組分析(Cohort Analysis)、病毒參數(Viral Coefficients)、跳出率(Bounce Rate)、
轉換率(Conversion Rate)、成長駭客(Growth Hacker)、成長駭客行銷(Growth Hacking)、
最低可行產品(Minimum Viable Product)、產品市場配適((Product Market Fit)、
銷售漏斗(Sales Funnel)。

2021年9月11日 星期六

消費者行為市場分析技術(下)

消費者行為市場分析技術:數據演算如何提供行銷解決方案
Marketing Analytics, 2nd edition, 
A practical guide to improving consumer insights using data techniques

麥可.格里斯比(Mike Grigsby)

第三篇 相互關係類型統計法
09 我的(消費者)市場概況如何?
- 欲展示各區隔市場,並證明彼此之間已有效區隔,需要用到的技術稱為「側寫」(profiling)。
一般而言,這可顯示各重要變數(尤其是較次數和對行銷媒介的回應)的平均數或頻率,
快速衡量每個區隔市場的差異。
注意,區隔市場之間的差異越大,(對各區隔市場實施的)策略會越明顯。
- 依區隔市場顯示關鍵績效指標(KPI)平均數的方法很常見,但很多時候,其他指標更能展現差異。
使用比率的話,時常可以更快突顯差異,亦即將各區隔市場的平均數除以整體平均數。
舉例來說,區隔市場A的平均營收為1500,區隔市場B的平均為750,總平均(整體市場總計)為1000。
將區隔市場A的平均數除以整體平均數1500/1000=1.5,也就是說,區隔市場A的營收比總平均多50%。相較之下,區隔市場B為750/1000=0.75,表示該區隔市場對營收的貢獻比總平均少25%。依區隔市場對所有數據算出比率,很快就能看出其中落差,尤其是差異甚小的情況特別明顯。
- 再舉個例子,區隔市場A的回應率是1.9%,整體回應率為1.5%。
雖然兩者(單一區隔市場和整體)表面上只相差0.4%,但換算成比率的話就是1.9%/1.5%,
亦即區隔市場A比總平均大27%。我們之所以喜歡(也應該)選用比率,原因在此。
- 雖然看見各區隔市場之間的龐大差異已夠令人滿意,但側寫最饒富趣味的地方往往在於命名每個區隔市場。開始之前,請先體認一點:為區隔市場命名有助於區分各市場,區隔的市場越多,命名越顯得重要。
- 判別分析可以輕鬆完成這項任務。
(在SAS程式中對樣本套用proc discrim指令,就能得到方程式,
依各消費者劃入各區隔市場的機率予以評分,一旦定義好類別「區隔市場」,就能在方程式中放入合適的變數,預測消費者所屬的類別「區隔市場」,這是很常見的做法)。
- 市場區隔探究的是對消費者重要的因素,而非企業。
- 市場區隔可為市場研究、行銷策略、行銷傳播和市場經濟等方面提供洞見。
- 務必釐清每個區隔市場自成一格的原因。每個區隔市場都應有不同的策略,否則劃分為區隔市場將無意義。

10 市場區隔
- 市場區隔的各種方法:
商業準則、卡方自動交互作用偵測、階層式集群分析法、K平均演算法集群分析、潛在類別分析等。
- 市場區隔的目標是要增加淨利,而每個區隔市場的最終目的,則是要有效運用策略,
創造交叉銷售及追加銷售的機會。
- 由分析中得出洞見,我們可以更認識每個區隔市場主要的痛點(pain point),
這也意味著我們可以對各市場對症下藥,
在適合的時機釋出適合的訊息,用足以打動人心的價格提供適當的產品選擇。
- 實際使用行為區隔程序:擬定策略、收集行為資料、製作/使用其他資料、執行選擇的演算法,以及側寫區隔市場。
- 區隔變數和側寫變數:
「區隔變數」是指建立區隔市場所使用的變數,剩下的變數則屬於「側寫變數」。
- 除此之外,其他(行為)變數都會以演算法檢測是否顯著,顯著者會保留下來,作為區隔變數。
總之請記住,只要不屬於區隔變數,即為側寫變數。
- 過度取樣(oversampling):強制提高特定數據代表性的一種取樣手法,使其樣本數比隨機取樣更多。
若簡單隨機取樣產生該特定數據的數量太少,即可採取過度取樣。
- 標準化:第一階段只是單純檢測每個變數是否「非常態」。
一般而言,此階段會計算每個變數的Z分數,或將各變數標準化,
接著刪去分數超過3.0標準差的觀察值
(常態分布下,三個標準差已涵蓋99.9%觀察值,因此超出者已屬於非常態)。
進入第二階段,需要使用K平均演算法檢測樣本是否為常態。
- 關鍵在於,比起逐一檢查每個變數是否異常,這種方法採取多自變數方式,
找到一群擁有非常態傾向的消費者。
因此我們需要刪除這些觀察項(消費者),不再繼續分析。
- 卡方自動交互作用偵測(chi-squared automatic interaction detection,CHAID)
- 卡方自動交互作用偵測會挑選依變數,接著檢視自變數,找出「區分」依變數效果最佳的自變數。
所謂效果「最佳」,是根據卡方檢測(chisquared test)的結果而論。
- RFM模型採用的是企業觀點,並非從消費者的角度出發。
- RFM模型只能試圖移動消費者版圖,無助於策略擬定。
- K平均演算法(k-means clustering)大概是最熱門的市場區隔(分析)的技術了。
SAS程式(使用proc fastclus)有相當強大的演算法。
- K平均演算法不具任何診斷功能,對於這些重要條件毫無任何協助,讓你憑著主觀的直覺全權決定。
-- 有幾點需要注意:
第一,K平均演算法方法以歐式距離平方根為依據,來決定觀察項的歸屬,因此並非統計屬性,而是數學性質的分析法。
第二,集群中心值(即集群)高度取決於資料集的順序。若將資料集重新排序,最後可能會得到天差地遠的區隔結果。
第三,此方法幾乎毫無診斷功能可言。
第四,由於群集呈現自然球形(因為是根據與中心值的距離,決定觀察值歸屬何處),集群的大小會很相似
這不太可能符合真實市場的情況。雖然K平均演算法又比RFM模型和卡方自動交互作用偵測更進一步,但顯然仍有許多缺陷。
- 市場數和顯著變數都不是K平均演算法能夠提供的資訊。
- 「行為區隔」是採消費者的觀點,主要使用消費者交易和行銷媒介回應等資料,
確切了解消費者看中的事情,其主要精神就是以消費者為核心。
所有策略行銷活動都適合使用「行為區隔」,包括:選擇目標客群、
訂定最佳折扣、了解消費者的通路偏好/決策歷程、釐清產品滲透率/品類管理等。
「行為區隔」不僅能協助行銷人員選擇目標市場,還能完成更多工作。
- 行為出自於動機,不管核心動機或經驗動機。
舉凡結帳、光臨店面、使用產品(滲透率)、開啟及點擊行銷媒介並給予回應,都是行為,
正是這些行為創造了財務成果、營收、成長、終身價值和利潤。
- 核心動機主要是無形的態度、品味和偏好、生活方式、金錢價值觀、通路偏好、益處或需求激發。
另外也有經驗動機,這是行為的次要成因,通常取決於品牌曝光。
這些都不是行為本身,但會觸發後續行為。這種次要成因包括:
忠誠度、互動程度、滿意度、服務禮節或速度。
值得留意的是,RFM模型使用的最近一次消費和頻率
(互動程度指標)就屬於次要成因,而同樣會使用的金額相關指標,則是財務結果數據。
- 由此可知,RFM模型僅使用互動和財務等方面的資料,並未使用行為資料。
- 「行為區隔」和RFM模型有三點不同:「行為區隔」(通常)使用較多行為資料;
「行為區隔」使用這些資料的目的在於了解消費者行為;「行為區隔」會採取統計方法,
將各區隔市場做最大程度的區分。
簡單比較RFM模型、卡方自動交互作用偵測、K平均演算法和潛在類別模型,即可窺得箇中意義。
RFM模型使用多個自變數(通常是三個變數),但無法處理多個依變數(即同時使用三種維度)。
RFM模型屬於數學性質的分析法,就統計而言並非理想選擇。
- 潛在類別分析(latent class analysis,LCA)可以大幅改善前述缺失,堪稱目前最先進的市場區隔技術。
- 潛在類別分析可找出理想的區隔市場數量、識別顯著變數,以及計算每一成員隸屬各個區隔市場的機率。簡言之,沒有任何事情需要主觀決定!
- 潛在類別分析是一種統計技術,而非數學性質的分析法(例如階層式分析或K平均演算法)。
- 潛在類別分析可以使用貝氏資訊準則(Bayes Information Criterion,BIC)、LL(負對數概似值)及錯誤率,為你提供診斷結果,在變數和資料集的基礎上,指出「最理想」的區隔市場。
- 潛在類別分析(LCA)是一種貝氏(最大概似)方法,具有統計本質。
由於消費者行為屬於一種機率(甚至是不理性的)現象,
因此使用統計分析法會比數學屬性的方法更為適切。
透過此方法提供的診斷功能,我們可以知道區隔市場的最佳數量,
也能了解哪些變數對市場區隔最為重要。

第四篇 攸關日常行銷的其他重要主題
11 統計檢定
- 試驗設計:以歸納方式建立統計測試,其中採用的刺激因素會隨機考量變異數、
信賴度等不同條件,並與控制組對照比較。
- 關於樣本規模的問題,建議考慮以下因素:
母體的標準差、希望的信賴水準(以檢測結果能否推斷母體的真實情形)、想檢測的敏感度,
以及預期回應。

12 結合大數據並採取大數據分析
- 歸因模式(attribution modelling)依行為區隔的結果,對各個接觸點施以加權。
策略上,若從產品組合的角度來看,我們可以從大數據中得知哪個接觸點對消費者具有價值。
因此,對於哪些消費者所重視的接觸點
(頁面、網站、網路、群組、社群、商店、部落格、具有影響力的名人等),我們就得多加注意。
- 不需要遍尋各種新奇的演算法,或是衍生出迥異的策略。
我們只需擁抱有關消費者行為的不同層次資訊,在分析時將所有相關因素納入考量。
對於此事,我們早就擁有相關的分析技術(存在好幾十年了)。
像是聯立方程式、結構方程式、向量自我迴歸等。
- 本書前幾個章節中,我們將廣義的統計分析技術區分成兩大類型:
依附方程式類型(一般迴歸、羅吉斯迴歸、存活分析模型),
以及相互關係類型的分析法(市場區隔、因素分析等)。
以下演算法使用的語言進一步擴展了前述定義,共區分為監督式學習、非監督是學習和強化學習:
1. 監督式學習:有一個引導(目標)變數,而目的就是預測該變數。
這類技術包括迴歸和分類類型的方法,例如決策樹(decision tree)、隨機森林(random forest)、
K最近鄰演算法(K-nearest neighbour)、邏輯迴歸等。
2. 非監督式學習:沒有引導變數。
市場區隔和降維(dimension reduction)類型的方法都屬於此類,
例如集群分析、類神經網路、因素分析等。
3. 主要運用人工智慧(AI),在演算法中融入回饋迴圈。
類似馬可夫鏈(Markov)的處理程序,一般都可歸於這類技術,例如Q-learning。
- 從技術面來看,截至目前所介紹的方法都屬於迴歸或分類屬性,具線性本質,
可表示為BXi,其大多僅涉及明顯的變數。也就是說,變數就是該方法要量測的項目。
除了這類型之外,還有一種非線性的技術(假定使用潛在變數),稱為「類神經網路」。
舉凡依變數類型即相互關係類型的技術(分類形式),都可使用類神經網路。
- 傳統的計量經濟方法依然足以解決大部分市場分析問題。